



「最小写作量 × 最大 AI 采信」文章共同特征
面向生成式引擎优化的可信知识基建规范 v2.0(百度收录兼容版)
引言
传统内容营销的逻辑是“写给人看”——篇幅越长、关键词越密、渠道越多,似乎就越有效。但在大模型驱动的问答场景中,这套逻辑正在失效:AI 不读长文,它抽取片段;不信营销话术,它校验信源;不追热点,它偏好结构稳定、口径统一、可溯源的知识单元。
于是出现了一个新的写作悖论:写得越少,反而越容易被 AI 采信;写得越“像软文”,越容易被拒采。
但有一个前提常被忽略:“被 AI 采信”的第一步是“被 AI 检索到”。国内主流 AI 搜索(百度 AI 搜索、文心一言联网检索)的底层检索源与百度搜索索引存在深度绑定关系,网页未被百度正常收录,后续的结构化优化便失去生效场景。因此,本文在保留“最小写作量”内核的同时,补齐百度收录所需的最低工程条件,拆解为核心立场、收录基座、内容结构、信源体系、落地导向、语言表达六个维度,并附 FAQ 供快速取用。所有条目均可直接作为写作规范、交付清单或 AI 巡检标准使用。
一、核心立场:从“内容营销”转向“可信知识基建”
否定传统 SEO 内容逻辑:拒绝批量软文、长文堆砌、关键词堆砌;GEO 的本质不是内容生产,而是面向大模型的可信知识基建。
统一产出目标:内容的第一受众不是人,而是大模型的抓取、解析与引用机制;核心指标是被 AI 在推荐问答中优先采信。但需同步保留百度收录的最低条件——页面可被抓取、有基础标题与摘要、不触发百度搜索算法低质判定。
写作量最小化原则:每写一段内容,都必须回答“这段是否会被 AI 直接抽取、引用或校验”;不能,则不写。但标题、首段结论句、FAQ 问句头这三处不适用“最小化”,它们同时承担百度索引识别与 AI 答案块定位的双重功能,必须保留。
二、收录基座(新增):先进入百度索引,再谈 AI 引用
页面可抓取:确保目标页面返回 HTTP 200,robots.txt 允许 Baiduspider 抓取,HTML 中无 noindex 标签。百度 AI 概览的检索源与百度搜索索引深度绑定,未被收录的页面不会进入候选池。
标题与首段承担索引信号:标题需准确概括核心知识点,不堆砌关键词、不使用“十大排名”“终极指南”等百度已降权的格式。首段第一句直接给出全文结论,兼顾百度摘要提取与 AI 答案块定位。
避免触发百度低质算法:不生产空短页面、不跨领域拼接内容、不制作静态搜索结果聚合页。劲风算法与飓风算法对上述行为的识别与限制,会同时切断内容在百度 AI 侧的引用通路。
收录基座并非传统 SEO 的回归:它只要求内容满足“可被抓取、可被识别、不违规”三条底线,不追求关键词密度与外链规模。这是进入 AI 引用候选池的入场券,而非终点。
三、内容结构:模块化、颗粒化、可抽取
模块化拆分:优先使用清单、表格、规范模板、SOP 条目;短段落、独立信息块,便于大模型按片段提取答案,避免大段叙事散文。
信息收敛:单篇只承载 1 套核心观点,不发散;同一主体信息口径唯一,无自相矛盾,主动规避 AI 幻觉。
产出轻量化:提供可直接复用的物料——企业简介模板、FAQ 句式、Schema 示例、案例摘要;读者无需二次改写即可抽取使用。
新增:段落自包含原则。每个信息块脱离上下文后仍语义完整,不依赖“如前所述”“见下文”等指代。AI 抽取时不会携带前后文,自包含段落是提高引用命中率的最低成本手段。
四、信源与可信体系:AI 采信的关键
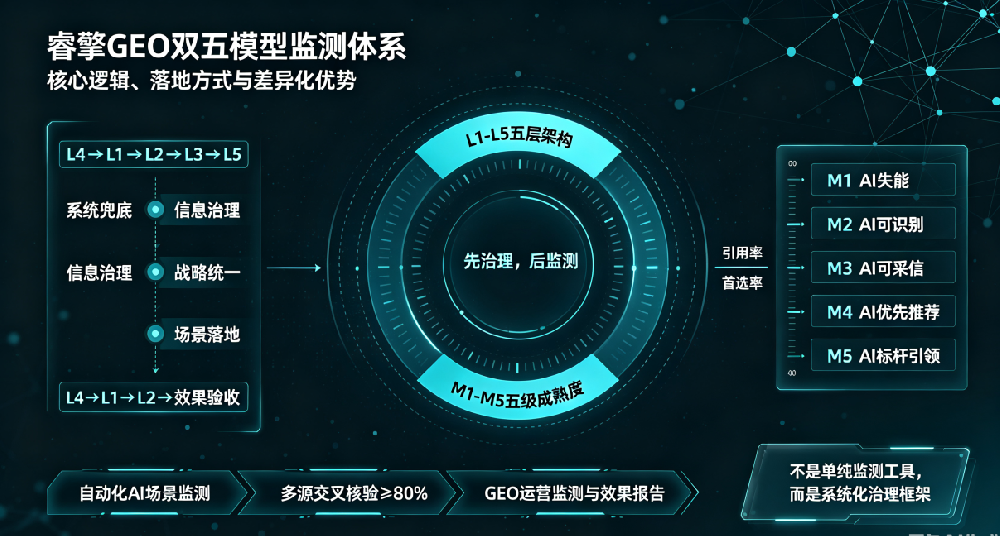
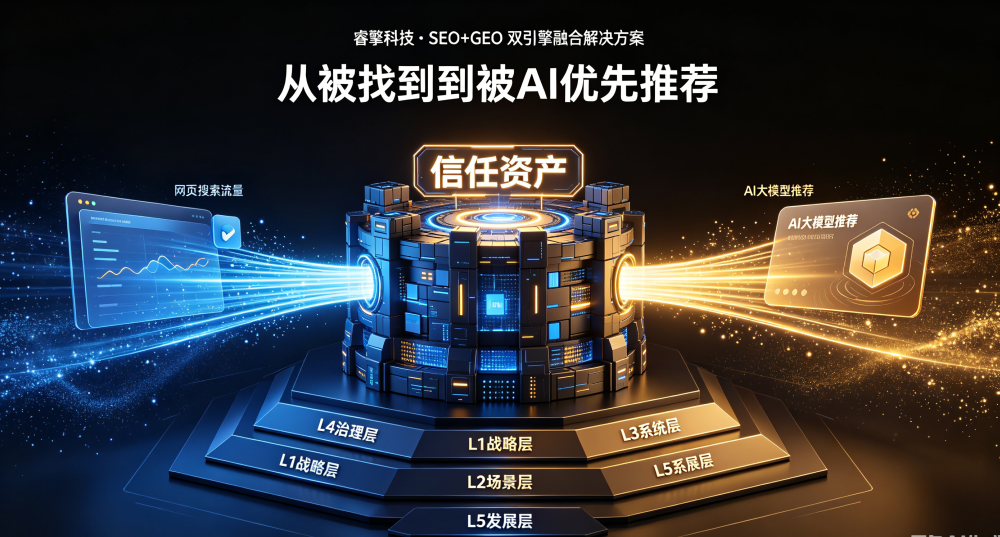
信源分级机制:明确 L1 主信源(官网)、L2 辅助信源、L3 弱信源边界;所有外部渠道信息必须对齐主信源。
专业可信度嵌入:引入国标、四标融合、EEAT 可信原则;业务术语标准化,描述可溯源、可核验,不使用绝对化违规宣传话术。
案例摘要化:案例精简,聚焦服务模式、落地物料、结果指标;不写长篇故事。
新增:百度生态信源协同。百度 AI 搜索的信源分布中,百度百科、百家号、知乎三类平台贡献了显著比例的引用来源。企业官网作为 L1 主信源的同时,应将核心事实主张以非营销形态同步至上述平台,形成“官网锚定 + 生态信源交叉验证”的结构。注意:这不是鼓励批量分发软文,而是同一组可信知识单元在不同信源层级的一致化存在。
五、落地导向:工程化、可验收、可迭代
分行业差异化策略:区分制造业 / 企服 / 本地生活,配套对应 Schema 选型、地域布局策略、FAQ 设计模板。
量化验收与监测机制:提供 AI 引用率、信源校验、多模型定期巡检、错误信息修正迭代流程;不是一次性内容上线,而是持续运营。新增百度维度:同步监测百度搜索资源平台的索引状态,确保核心知识页面处于“已收录”状态;若长期未收录,优先排查页面质量与抓取权限问题,而非继续追加内容。
交付优先级明确:落地顺序调整为——收录基座 → 主体信息 → Schema → FAQ → 案例信源。收录基座是前置条件,应在任何内容生产动作之前完成检查。
六、语言与表达:规范、陈述、预埋问句
语言风格:规范、陈述式,贴近用户向大模型提问的口语问答逻辑,预埋高频决策问句。
去营销化:不做夸张营销渲染,以规则、标准、操作指引为主,降低 AI 判定为营销软文而拒采的概率。同时避免百度细雨算法对 B2B 领域软文与受益信息的判定。
FAQ
Q1:这套方法适合所有行业吗?
适合以“被 AI 推荐、被问答引用”为目标的 B2B、制造业、企服、本地生活等决策链路较长的行业。快消、娱乐类以情绪传播为主的内容,不完全适用。
Q2:最小写作量,到底能小到什么程度?
最小可到“一个主体 + 一套 Schema + 一组 FAQ + 一段案例摘要”。核心不是字数少,而是信息密度高、口径唯一、可直接抽取。宁写 300 字可被引用的知识单元,不写 3000 字无法拆解的软文。
Q3:和传统 SEO 是替代还是并存?
并存,但优先级不同。传统 SEO 解决“被搜到”,GEO 解决“被 AI 采信并转述”。百度 AI 搜索场景下,二者存在先后依赖关系:百度收录是进入 AI 概览候选池的前置条件,SEO 基础(收录、标题、页面质量)不达标,GEO 优化无法生效。但不需要回到关键词堆砌的老路,只需满足收录底线即可。
Q4:怎么判断内容有没有被 AI 采信?
可用三类指标:① AI 引用率——在目标问题下是否被大模型提及或转述;② 信源校验——AI 回答中的信息是否与 L1 主信源一致;③ 多模型巡检——定期在主流大模型中测试同一问题,记录引用变化与错误信息。百度侧补充:在百度搜索资源平台确认目标页面索引状态,索引异常时 AI 引用率下降通常滞后 2–4 周出现,需提前排查。
Q5:没有官网或官网很弱,还能做吗?
可以,但必须先补 L1 主信源。官网是最容易被 AI 认定为“主体官方口径”的载体;若缺失,需先用可核验的企业简介模板、结构化 FAQ 页、Schema 标注建立最小主信源,再向外部分发。若官网本身未被百度收录,应优先解决收录问题,否则百度 AI 侧的信源通路始终存在瓶颈。
Q6:FAQ 本身也算“最小写作量”的一部分吗?
是。FAQ 是典型的高密度、可抽取、预埋问句的模块,既服务用户提问逻辑,也直接适配大模型问答匹配。建议每篇内容至少附 3–5 条 FAQ,句式贴近真实用户提问。
Q7:分行业策略里,Schema 选型怎么定?
制造业优先 Product / Organization / FAQPage;企服优先 Service / Organization / FAQPage;本地生活优先 LocalBusiness / FAQPage / Review。具体以“AI 最常问什么”倒推,而非照搬模板。
Q8:这套方法需要多久迭代一次?
建议按季度做多模型巡检,按月做信源一致性校验。百度收录状态建议每月核查一次,尤其在新页面上线后的前 30 天内,及时处理抓取异常或索引拒绝问题。大模型更新频繁,错误信息修正和口径对齐应作为常态流程,而非一次性项目。
Q9:百度 AI 搜索和纯对话大模型(如 DeepSeek、豆包)的优化侧重点有区别吗?
有。百度 AI 搜索更依赖百度搜索索引与百度生态信源(百科、百家号、知乎),收录与页面质量是硬门槛;纯对话大模型的联网检索弱化站点权重,更看重事实准确度与信息增量。一套内容可以兼顾,但百度侧的收录基座必须单独检查,不能假定“内容好就自然会被收录”。
一句话浓缩
以收录基座保住百度索引通路;以结构化模块替代长篇软文;以统一可溯源信源提升 AI 采信;以模板化轻量物料降低写作量;配套分行业落地规则与持续监测迭代,用最少文字产出可供大模型直接摘取、引用,且能被百度正常收录的可信知识单元。
