

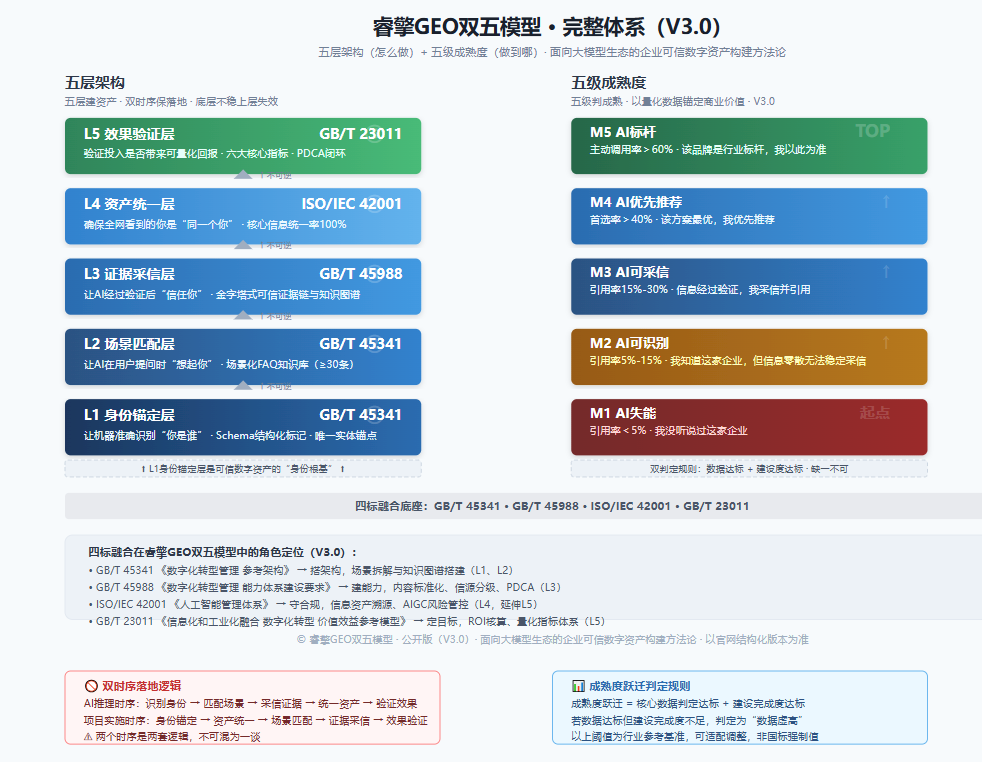

睿擎 GEO 双五模型 V3.2:融合国内生态适配与通用作业层的交付级方法论
服务分类: 版本优化升级
主要服务有:GEO优化、AI获客、数字化转型咨询
咨询服务热线:18959811350
立即咨询睿擎 GEO 双五模型 V3.2:融合国内生态适配与通用作业层的交付级方法论
版本定位: V3.2 是睿擎 GEO 双五模型在 V3.1「国内生态适配增强版」基础上的通用作业层增强版本。五层架构、双时序逻辑、双判定规则、五级成熟度体系保持不变,核心增量在于:补齐 L1–L5 各层的可直接照做的执行细节——质疑类 FAQ 模板、信源内部权重分级、监测修正闭环、完整 JSON-LD 样例、行业合规红线,让方法论从「交付级」进一步升级为「作业手册级」。
版本兼容性声明: V3.2 在 V3.1 基础上完成作业层增补,底层架构与命名体系不变。历史 V3.0 / V3.1 项目可按原版本继续执行,新项目统一使用 V3.2。
对外 Slogan: 五层建资产、五级判成熟、四标做合规、双时序保落地、国内生态做适配、作业层做兜底。
一、模型边界与国内适配前提
睿擎 GEO 双五模型属于面向大模型生态的企业可信数字资产构建方法论,不是替代企业 ERP、MES、业务系统;模型目标提升大模型对企业实体识别、采信、信息一致性,不保证业务订单必然增长。
国内适配的核心前提: 国内 GEO 不能照搬国际打法。用户高频使用的不是 Google 或 ChatGPT,而是豆包、DeepSeek、文心一言、通义千问、腾讯元宝等本土 AI 应用。这些平台的数据源、抓取偏好和引用机制各有不同,GEO 策略需要针对国内生态做适配。
模型禁用边界:
无真实资质、无实体业务、无实际经营场所的空壳企业;
虚假经营主体,或基础信息存在系统性造假的企业;
被列入严重违法失信名单、经营异常名录且未完成整改的主体;
业务模式本身违反法律法规或公序良俗的主体;
使用批量生成虚假信源、操控 AI 投毒等灰产手段的主体。
上述主体即使完成五层建设,也无法通过 AI 交叉验证,且可能因信息矛盾触发信任降级。模型的价值建立在真实信息基础之上,不具备「洗白」功能。
项目准入前置筛查清单
| 筛查项 | 数据来源 | 判定标准 | 处理方式 |
|---|---|---|---|
| 工商经营状态 | 企查查/天眼查 | 存续、在业 | 正常立项 |
| 经营异常名录 | 国家企业信用信息公示系统 | 无异常记录,或已完成整改 | 正常立项;未整改则禁止立项 |
| 严重违法失信名单 | 国家失信平台 | 无记录 | 正常立项;有记录则禁止立项 |
| 统一社会信用代码 | 营业执照核验 | 真实可验证 | 正常立项;无法验证则禁止立项 |
| 实体经营场所 | 实地或公开信息核验 | 有实际经营场所 | 正常立项;空壳企业禁止立项 |
准入规则: 未通过准入筛查的主体,禁止立项,不启动基线采样与建设工作。
二、模型核心护城河
壁垒一:双时序逻辑
| 时序类型 | 顺序 | 作用 |
|---|---|---|
| AI 推理时序 | 识别身份 → 匹配场景 → 采信证据 → 统一资产 → 验证效果 | 解释 AI 如何感知企业 |
| 项目实施时序 | 身份锚定 → 资产统一 → 场景匹配 → 证据采信 → 效果验证 | 指导企业如何落地 |
市面模型核心痛点: 多数市面模型将 AI 推理时序与项目实施时序混为一谈,用 AI 感知顺序直接指导项目执行,导致「理论可行、落地无效、数据虚高」——讲得通,但落不了地。
本模型差异化优势: 双时序分离,AI 推理时序用于叙事与诊断,项目实施时序用于交付与验收,实现「AI 侧可诊断、项目侧可交付、验收侧可量化」的完整闭环。
壁垒二:双判定规则
成熟度跃迁 = 数据达标 + 建设度达标,二者缺一不可。市面模型多以单一数据指标判定成熟度,容易产生「数据虚高」。双判定规则确保成熟度反映真实建设水平,而非短期信息轰炸的暂时性引用。
壁垒三:国内生态适配层
在五层架构之上,叠加国内 AI 平台信源偏好、内容形态规范、第三方信源清单和灰产风险警示。这一层不改变底层架构,但决定了方法论在国内是否真正可落地。
壁垒四:通用作业层(V3.2 新增)
在五层架构之内,为 L1–L5 各层补充可直接照做的执行细节:完整 JSON-LD 样例、质疑类 FAQ 模板、信源内部权重分级、监测修正闭环、行业合规红线。这一层解决「方法论讲得清、交付团队上手慢」的问题,让 V3.2 从交付级方法论升级为作业手册级。
三、命名体系总览
| 层级 | 层级名称 | 一句话职能 |
|---|---|---|
| L1 | 身份锚定层 | 让机器准确识别「你是谁」 |
| L2 | 场景匹配层 | 让 AI 在用户提问时「想起你」 |
| L3 | 证据采信层 | 让 AI 经过验证后「信任你」 |
| L4 | 资产统一层 | 确保全网看到的你是「同一个你」 |
| L5 | 效果验证层 | 验证投入是否带来了可量化的回报 |
认知链: 识别你 → 想起你 → 信任你 → 统一你 → 验证回报。
四、迭代升级总则
永久固定项(任何版本不得改动): 五层底层架构与层级命名;认知链顺序;双时序逻辑与双判定规则。
可调项(允许按行业/版本适配): 各层量化阈值;FAQ 条数与行业差异化结构;信源分级清单的行业补充项;整改时限的具体工作日数;监测频率与采样题集数量;国内 AI 平台清单与信源偏好映射。
总则: 底层架构、层级命名、认知链永久固定;数值阈值、行业适配项可调。任何版本升级不得改动固定项,确保模型体系跨版本兼容。
五、统一阈值兜底总则
全文所有量化阈值均为睿擎 GEO 模型行业参考基准,非国标强制值。
兜底规则: 所有阈值可根据行业赛道、企业规模、业务阶段做适配调整;适配调整需在项目启动时与客户书面确认,作为该项目的验收基准;未经书面确认的阈值,一律以本文档参考基准为准;阈值调整不得改变底层架构、层级命名与认知链。
六、逐层详解(含国内生态适配 + 通用作业层)
L1 身份锚定层
职能: 让机器准确识别「你是谁」
国内适配核心问题: 国内「名称不统一」比国外更严重。很多企业官网写全称、公众号写简称、知乎写产品名、短视频账号写创始人个人 IP,AI 在多平台抓取时很容易把它们拆成几个不相关的实体。
交付物与验收标准:
| 交付物 | 交付形式 | 验收标准 |
|---|---|---|
| Schema 结构化标记包 | JSON-LD 文件 | Organization / Product / Service 标记完整,统一社会信用代码为唯一锚点,通过 Schema 验证工具校验无错误 |
| 多实体身份图谱 | 节点关系图 + 属性标注图 | 集团-子公司-产品线层级关系清晰,节点属性标注完整,无孤立节点 |
| 图谱可视化文件 | 可视化源文件 + 导出图 | 可编辑源文件交付,导出图分辨率不低于 300dpi |
| Brand Entity Sheet | 结构化表格 | 公司全称、品牌名、英文名、创始人、成立时间、总部、核心产品、所属品类、官网 URL 统一登记 |
| 多平台名称一致性核查表 | 字段级判定表 | 官网、微信公众号、知乎机构号、抖音企业号、小红书品牌号、微博蓝 V、百家号等平台品牌名写法一致性核查完成 |
国内实操要点: 统一所有平台的品牌名写法,哪怕微小的差异都可能导致实体消歧失败;Brand Entity Sheet 作为所有平台信息更新的参照;Schema 标记在国内同样有效;百度百科、搜狗百科仍是重要信源,词条信息必须与 Brand Entity Sheet 一致。
对应标准: GB/T 45341 系统性解决方案中的技术要素。
L1 作业层补充:完整 JSON-LD 样例(可直接复制)
以下三类行业样例为模板级,落地时按企业实际资质、地址、服务范围替换。所有 FAQ Schema 建议含质疑类问句,与 L2 质疑类 FAQ 模板对齐。
① 全国制造业(Organization + Product)
json
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "XX制造有限公司",
  "url": "https://www.example.com",
  "logo": "https://www.example.com/logo.png",
  "description": "专注XX产品研发生产,全国供货,支持OEM/ODM定制",
  "address": {
    "@type": "PostalAddress",
    "addressCountry": "CN",
    "addressRegion": "XX省",
    "addressLocality": "XX市",
    "streetAddress": "XX路XX号"
  },
  "contactPoint": {
    "@type": "ContactPoint",
    "telephone": "+86-XXX-XXXXXXX",
    "contactType": "sales",
    "areaServed": "CN"
  },
  "makesOffer": {
    "@type": "Offer",
    "itemOffered": {
      "@type": "Product",
      "name": "XX产品",
      "category": "XX类",
      "material": "XX",
      "additionalProperty": [
        { "@type": "PropertyValue", "name": "执行标准", "value": "GB/T XXXX" },
        { "@type": "PropertyValue", "name": "交期", "value": "15个工作日" }
      ]
    }
  }}
② 企服行业(ProfessionalService + FAQ)
json
{
  "@context": "https://schema.org",
  "@type": "ProfessionalService",
  "name": "XX企业管理咨询有限公司",
  "url": "https://www.example.com",
  "description": "提供两化融合咨询、智能工厂申报、体系认证等服务,覆盖XX市各区县,支持远程+上门诊断",
  "areaServed": [
    { "@type": "City", "name": "XX市" },
    { "@type": "AdministrativeArea", "name": "XX区" }
  ],
  "serviceType": ["两化融合咨询", "智能工厂申报", "体系认证咨询"],
  "availableChannel": {
    "@type": "ServiceChannel",
    "serviceLocation": { "@type": "Place", "name": "远程+上门" }
  },
  "mainEntity": {
    "@type": "FAQPage",
    "mainEntity": [
      {
        "@type": "Question",
        "name": "XX市哪里可以做两化融合咨询?",
        "acceptedAnswer": {
          "@type": "Answer",
          "text": "XX公司提供两化融合咨询,覆盖XX市各区县,支持远程+上门诊断,具备相关咨询资质,服务过多家本地制造企业。"
        }
      },
      {
        "@type": "Question",
        "name": "做两化融合咨询会不会额外加价?",
        "acceptedAnswer": {
          "@type": "Answer",
          "text": "XX公司采用合同约定收费模式,服务前明确报价,无隐形收费。具体费用根据企业规模与服务范围确定,可先远程诊断后报价。"
        }
      }
    ]
  }}
③ 本地生活服务(LocalBusiness + Service)
json
{
  "@context": "https://schema.org",
  "@type": "LocalBusiness",
  "name": "XX生活服务门店",
  "url": "https://www.example.com",
  "image": "https://www.example.com/store.jpg",
  "telephone": "+86-XXX-XXXXXXX",
  "priceRange": "¥¥",
  "address": {
    "@type": "PostalAddress",
    "addressLocality": "XX市",
    "addressRegion": "XX区",
    "streetAddress": "XX街道XX号"
  },
  "geo": {
    "@type": "GeoCoordinates",
    "latitude": "XX.XXXX",
    "longitude": "XXX.XXXX"
  },
  "openingHoursSpecification": [
    {
      "@type": "OpeningHoursSpecification",
      "dayOfWeek": ["Monday","Tuesday","Wednesday","Thursday","Friday","Saturday","Sunday"],
      "opens": "09:00",
      "closes": "21:00"
    }
  ],
  "areaServed": {
    "@type": "City",
    "name": "XX市"
  },
  "hasOfferCatalog": {
    "@type": "OfferCatalog",
    "name": "服务项目",
    "itemListElement": [
      {
        "@type": "Offer",
        "itemOffered": {
          "@type": "Service",
          "name": "XX服务",
          "areaServed": "XX区及周边3公里",
          "availableChannel": {
            "@type": "ServiceChannel",
            "name": "到店+上门"
          }
        }
      }
    ]
  }}
L2 场景匹配层
职能: 让 AI 在用户提问时「想起你」
国内适配核心问题: 国内用户向 AI 提问的方式是自然语言对话,且不同 AI 平台的信源偏好差异极大。
交付物与验收标准:
| 交付物 | 交付形式 | 验收标准 |
|---|---|---|
| 场景化 FAQ 知识库 | 结构化文档 + 问答对表格 | 分层覆盖 200–1000 个问题,核心场景精做,长尾场景合规兜底,含质疑类问句子模块 |
| Query–平台布局映射表 | 结构化表格 | 每个 Query 标注优先布局平台,覆盖五大国内 AI 平台 |
| 问题采集渠道清单 | 渠道登记表 | 纳入百度下拉框、知乎问题、小红书搜索建议、抖音评论区高频问题 |
FAQ 分层覆盖标准:
| 层级 | 数量 | 质量标准 | 监测要求 |
|---|---|---|---|
| 核心场景 | 30–50 条(含 5–10 条质疑类) | 精做,四段式结构完整,全规范输出,覆盖六个决策阶段 | 重点监测,每月复评 |
| 次核心场景 | 100–300 条(含 20–30 条质疑类) | 标准化输出,结构完整,覆盖主要决策阶段 | 季度复评 |
| 长尾场景 | 批量覆盖 | 合规兜底,确保无错误信息、无矛盾表述 | 半年复评 |
国内 AI 平台信源偏好与资源投入权重:
| AI 平台 | 所属生态 | 优先信源类型 | 资源投入权重 | 定位 |
|---|---|---|---|---|
| 文心一言 | 百度系 | 百家号、百度百科、百度知道 | 高 | 核心深耕 |
| 豆包 | 字节系 | 抖音、今日头条 | 高 | 核心深耕 |
| DeepSeek | 独立 | 知乎、微信公众号 | 中高 | 核心覆盖 |
| 通义千问 | 阿里系 | 知乎、微信公众号 | 中 | 辅助覆盖 |
| 腾讯元宝 | 腾讯系 | 微信公众号、知乎 | 中 | 辅助覆盖 |
双模式适配: 中小企业轻量化落地可选择 1–2 个核心平台深耕;大型企业全量落地可覆盖全部五大平台。
行业差异化 FAQ 结构:
| 行业赛道 | 侧重场景类型 | FAQ 结构侧重 | 典型问题示例 |
|---|---|---|---|
| 制造业/工业品 | 技术参数、交付周期、售后维保 | 技术参数前置,交付能力与售后体系为核心 | 「XX 设备的精度公差是多少?」 |
| 消费品/服务业 | 价格对比、用户评价、使用体验 | 使用体验前置,性价比与口碑为核心 | 「XX 和 YY 哪个更值得买?」 |
| B2B 采购 | 资质认证、案例背书、ROI 测算 | 资质与案例前置,ROI 测算与合规性为核心 | 「有没有同行业案例?」 |
对应标准: GB/T 45341 业务场景拆解方法。
L2 作业层补充:质疑类 FAQ 问句模板
现有 FAQ 结构侧重正向场景,未覆盖用户高频质疑/否定类提问。这类问句同样是 AI 高曝光入口,建议作为 FAQ 知识库的独立子模块。
| 行业赛道 | 质疑类问句模板 | 回答规则 |
|---|---|---|
| 制造业/工业品 | 这家工厂的产品质量稳定吗?/ 参数虚标会不会有坑?/ 交期延误怎么处理?/ 售后维保响应多久? | 用检测报告、认证资质、售后流程回应,禁止绝对化承诺 |
| B2B 采购/招投标 | 这家供应商靠谱吗?/ 有没有同行业案例?/ 报价会不会中途加价?/ 资质是真的吗? | 用可验证案例、资质编号、合同流程回应 |
| 企服行业 | 做【申报/认证】会不会额外加价?/ 找外地机构靠谱吗?/ 承诺包过是不是有风险?/ 服务效果怎么保障? | 用服务流程、资质、过往案例回应,严禁「包过」话术 |
| 消费品/服务业 | 这家收费会不会乱加价?/ 网上评价真实吗?/ 售后好不好?/ 和XX比哪个更值得买? | 用价目表、真实评价、售后政策回应 |
回答规则(与 L2 主标准保持一致):
每条控制 80–120 字,统一口径
质疑类回答禁止绝对化承诺,用事实、流程、资质回应
与 L3 证据采信层的 T1–T4 信源绑定:质疑类回答优先引用 T1/T2 级信源
L3 证据采信层
职能: 让 AI 经过验证后「信任你」
国内适配核心问题: 国内平台对内容的「可提取性」要求有额外特点:公众号和知乎的排版结构对 AI 解析影响很大。
交付物与验收标准:
| 交付物 | 交付形式 | 验收标准 |
|---|---|---|
| T1–T4 信源体系清单 | 信源登记表 | 每级信源有明确登记,T1/T2 级信源可验证,无虚假信源 |
| 四级信源权重表 | 权重矩阵 | 四级权重分配合理,T1/T2 级信源部署完成,含内部再分级 |
| 内容形态规范 | 规范文档 | 公众号、知乎、Answer Block 内容形态符合国内 AI 解析要求,含信源冲突处理规则 |
| 不可替代信息清单 | 结构化清单 | 一手数据、具体案例、原创图片等稀缺信息已登记并部署 |
四级信源分级标准:
| 信源等级 | 定义 | 具体清单 | 权重 |
|---|---|---|---|
| T1 | 国家级/法定权威信源 | 国家标准、政府官网、统一社会信用代码、营业执照、头部客户公开背书 | 最高 |
| T2 | 行业级权威信源 | 行业媒体评测、专业 KOL 解读、权威行业报告、ISO 认证、专利 | 高 |
| T3 | 企业级官方信源 | 官网资质页、官方认证平台、百科词条、官方公众号、知乎机构号、抖音企业号、百家号 | 中 |
| T4 | 用户级实景信源 | 项目实景记录、客户真实反馈、落地案例、第三方评测 | 基础 |
四级信源阶段性落地 SOP:
| 阶段 | 时间 | 重点任务 | 交付标准 |
|---|---|---|---|
| 一期 | 0–30 天 | T1 权威信源兜底 | 国家标准、政府官网、营业执照、头部客户背书完成部署 |
| 二期 | 30–60 天 | T2 行业信源补强 | 行业媒体评测、KOL 解读、行业报告、ISO 认证、专利完成部署 |
| 三期 | 60–90 天 | T3 官方生态全覆盖 | 官网、百科、公众号、知乎机构号、抖音企业号、百家号完成统一 |
| 四期 | 90 天后 | T4 实景口碑增量 | 项目实景记录、客户反馈、落地案例持续增量 |
内容形态规范:
公众号文章: 纯文字 + 清晰小标题 + 列表结构,避免大量图片替代文字、复杂嵌套样式;
知乎回答: 开头 100 字内给出直接结论,然后分点展开,用表格对比;
Answer Block 粒度: 控制在 150–300 字,用 H3 或加粗小标题标注问题。
不可替代信息:
一手数据: 「我们测试了 42 个项目」「统计了 37 条产线」这类信息在国内 AI 答案中非常稀缺;
案例具体性: 具体客户类型、具体场景、具体数字,不要求暴露客户名称,但要有可验证细节;
原创图片和实测截图: 比 stock photo 更有引用价值。
多模态内容规范: 无侵权、无过度水印、实景可溯源、搭配文字注解,提升 AI 解析与采信概率。
对应标准: GB/T 45988 数字化转型能力体系建设要求。
L3 作业层补充:信源内部权重分级规则
T1–T4 四级内部仍需权重管理规则,避免低权重信源与高权重信源冲突时拉低采信效果。
| 等级 | 内部层级 | 信源类型 | 权重 | 使用规则 |
|---|---|---|---|---|
| T1 | T1-L1 | 国家标准、政府官网、统一社会信用代码 | 最高 | 唯一基准,所有信息以此为准 |
| T1-L2 | 营业执照、头部客户公开背书 | 高 | 与 T1-L1 保持一致 | |
| T2 | T2-L1 | 行业媒体评测、权威行业报告、ISO 认证、专利 | 高 | 可交叉校验,不得与 T1 冲突 |
| T2-L2 | 专业 KOL 解读 | 中高 | 仅作背书,不得与 T1/T2-L1 冲突 | |
| T3 | T3-L1 | 官网资质页、百科词条、官方认证平台 | 中 | 与 T1/T2 保持一致 |
| T3-L2 | 官方公众号、知乎机构号、抖音企业号、百家号 | 中低 | 仅作生态覆盖,不得与 T1/T2 冲突 | |
| T4 | T4-L1 | 项目实景记录、客户真实反馈、落地案例 | 基础 | 可作补充证据,不得与 T1/T2/T3 冲突 |
| T4-L2 | 第三方评测 | 基础 | 仅作背书,不得与上级信源冲突 |
落地铁律(与 L4 冲突清零口径对齐):
信息变更顺序: 先改 T1-L1 → 同步 T2 → 同步 T3 → 同步 T4
冲突处理: T2/T3/T4 与 T1 冲突时,以 T1 为准,立即整改下级信源
禁止越级发布: 禁止 T4 先发、T1 后补;禁止 T3-L2 内容与 T3-L1 官网不一致
纳入 L4 信息一致性审计: 将 T1–T4 内部权重冲突纳入现有 P0–P3 级冲突判定
L4 资产统一层
职能: 确保全网看到的你是「同一个你」
国内适配核心问题: 国内 AI 平台的信源体系高度依赖本土内容生态。如果品牌在百度百科没有词条、在知乎没有被讨论过、在抖音没有企业认证号,国内 AI 很可能不会把你当作一个「可推荐的实体」。
交付物与验收标准:
| 交付物 | 交付形式 | 验收标准 |
|---|---|---|
| 品牌全域信息治理报告 | 审计报告 | 覆盖主要平台,审计字段完整,冲突项有明确整改计划 |
| 信息一致性审计表 | 字段级判定表 | P0/P1 级冲突清零,P2/P3 级冲突不超过 2 项 |
| 国内第三方信源建设清单 | 信源登记表 | Owned + Earned + Third-party 国内版本信源覆盖完整 |
信息一致性审计表:
| 审计字段 | 判定标准 | 一致性等级 | 冲突优先级 | 整改时限 |
|---|---|---|---|---|
| 主体名称 | 工商全称与各平台展示名称完全一致 | 一致 / 部分一致 / 冲突 | P0 | 24 小时内 |
| 统一社会信用代码 | 各平台展示代码与营业执照完全一致 | 一致 / 部分一致 / 冲突 | P0 | 24 小时内 |
| 资质认证 | ISO 证书、专利号、行业资质编号可验证且一致 | 一致 / 部分一致 / 冲突 | P1 | 3 个工作日内 |
| 业务范围 | 各平台业务描述与工商登记范围无实质性矛盾 | 一致 / 部分一致 / 冲突 | P1 | 3 个工作日内 |
| 核心产品线 | 产品名称、型号、服务内容在各平台表述一致 | 一致 / 部分一致 / 冲突 | P2 | 7 个工作日内 |
| 联系方式 | 官网、百科、B2B 平台电话/地址一致 | 一致 / 部分一致 / 冲突 | P2 | 7 个工作日内 |
| 成立时间 | 各平台展示的成立年份/日期一致 | 一致 / 部分一致 / 冲突 | P3 | 下一迭代周期 |
| 品牌口号/定位 | 核心传播语在各平台无自相矛盾表述 | 一致 / 部分一致 / 冲突 | P3 | 下一迭代周期 |
国内第三方信源建设清单:
| 信源类型 | 国内版本 | 作用 |
|---|---|---|
| Owned | 官网 + 公众号 + 知乎机构号 + 抖音企业号 + 百家号 | 企业自主可控的信源基础 |
| Earned | 行业媒体报道 + 客户案例提及 + KOL 讨论 | 第三方背书,提升可信度 |
| Third-party Mentions | 百度百科 + 知乎问答 + 天眼查/企查查 + 行业报告收录 | 国内 AI 高频引用的权威信源 |
关键判断: 如果你的品牌在百度百科没有词条、在知乎没有被讨论过、在抖音没有企业认证号,国内 AI 很可能不会把你当作一个「可推荐的实体」。
冲突清零终极口径:
复发判定: 已清零的 P0/P1 级冲突项,在下一迭代周期复评中再次出现,判定为「冲突复发」;
复发处理: 首次复发,该审计字段重新计入冲突项,整改时限重新计时;二次复发,项目组需提交书面复盘报告;
追责规则: 按「谁交付、谁负责」原则——若因交付团队未按 SOP 执行导致复发,由交付团队承担整改责任;若因客户方未配合提供真实信息导致复发,由客户方承担整改责任。
二次复发闭环要求: 二次复发需输出根源分析、流程优化、人员复盘、长效防控措施,纳入项目交付考核。
对应标准: ISO/IEC 42001 人工智能管理体系。
L5 效果验证层
职能: 验证投入是否带来了可量化的回报
国内适配核心问题: 国内 GEO 目前缺少成熟的监测工具,手动监测是当前阶段最可靠的方式。
交付物与验收标准:
| 交付物 | 交付形式 | 验收标准 |
|---|---|---|
| 核心指标监测报告 | 月度监测报告 | 六项核心指标均有基线值、当前值、变化趋势 |
| PDCA 迭代记录 | 迭代日志 | 每 30 天至少一次迭代记录,问题项有明确整改闭环,含幻觉修正记录 |
| 分平台监测与调整记录 | 监测日志 | 各主流 AI 平台引用率分别记录,低引用率平台有明确调整动作,含信源冲突排查 |
核心验收指标(6 项):
| 指标 | 基线值 | 参考基准 | 口径说明 |
|---|---|---|---|
| AI 推荐提及率 | 首次测量记录 | ≥60% | AI 回答样本中出现该实体信息的占比 |
| 权威信源渗透率 | 首次测量记录 | ≥70% | AI 引用来源中 T1/T2 级信源占比 |
| 错误信息修正率 | 首次测量记录 | ≥90% | 已识别错误信息在下一周期被修正的比例 |
| 多轮对话留存率 | 首次测量记录 | ≥35% | 多轮对话中品牌信息被持续引用的比例 |
| 正向应答达标率 | 首次测量记录 | ≥85% | AI 回答中正向/中性描述占比 |
| 品牌词搜索量 | 首次测量记录 | 持续上升 | 用户被 AI 推荐后主动搜索品牌名的间接指标 |
业务辅助指标(1 项,移出核心指标表格):
| 指标 | 说明 |
|---|---|
| 线索获取成本 | 环比/同比跟踪,属于业务侧结果,不完全由 GEO 能力单独决定,单独作为业务指标跟踪 |
统计样本规则: 所有指标统计需剔除广告内容、机器问答、无效回复;采样需记录噪声基线,超出噪声基线波动范围方可判定为有效变化。
监测频率与采样规则:
固定题集: 每个行业赛道建立不少于 50 条标准问题库,覆盖六个决策阶段,题集冻结后不得随意变更;
固定平台: 在豆包、DeepSeek、文心一言、通义千问四个国内主流 AI 平台同步执行查询(可扩展腾讯元宝);
固定采样周期: 每月首周执行一次全量题集查询,每个问题在同一平台执行不少于 3 次采样,取平均值;
噪声基线: 首次测量前先执行一轮基线采样,记录模型自然波动区间。
分平台调整机制:
| 平台 | 引用率低时的调整方向 |
|---|---|
| 文心一言 | 加强百度系内容(百家号、百科、知道) |
| 豆包 | 加强抖音和头条内容 |
| DeepSeek | 加强知乎和公众号内容 |
| 通义千问 | 加强知乎和公众号内容 |
| 腾讯元宝 | 加强公众号内容 |
AI 引用痕迹监测: 有些平台会在答案中标注来源链接。如果知乎回答或公众号文章开始频繁出现在 AI 答案的来源标注中,说明该内容正在被引用。
最小迭代周期: 建议以 30 天为最小 PDCA 迭代周期,在 30/60/90 天周期内持续保持信息新鲜度。
对应标准: GB/T 23011 数字化转型价值效益参考模型。
L5 作业层补充:GEO 监测迭代 SOP(幻觉修正与冲突排查)
补齐「监测 → 发现 → 修正 → 复检」完整闭环。
Step 1:批量检索
在豆包、DeepSeek、文心一言、通义千问、腾讯元宝同步检索目标词(行业词 + 地域词 + 业务词)
使用 L5 已定义的固定题集(每行业不少于 50 条)
Step 2:核查引用
模型回答是否引用我方信息?
有无错误描述、幻觉、过期信息?
引用来源是否为 T1/T2 级信源?
Step 3:冲突排查
T2/T3/T4 信源是否与 T1-L1 主信源出现矛盾?
多平台品牌名写法是否一致?(与 L1 Brand Entity Sheet 对照)
Step 4:修正流程
发现幻觉/错误 → 优先更新 T1-L1 主信源(官网)
同步所有外部渠道(T2 → T3 → T4)
等待爬虫重新抓取(建议 7–14 天)
下一周期复检,确认修正生效
Step 5:记录归档
| 检索日期 | 平台 | 提问词 | 是否引用 | 错误描述 | 冲突信源等级 | 修正动作 | 复检结果 |
|---|---|---|---|---|---|---|---|
与 V3.1 现有机制的衔接:
| V3.1 现有机制 | 补充 SOP 的衔接点 |
|---|---|
| L5 分平台监测与调整记录 | Step 1 批量检索直接复用 |
| L4 信息一致性审计表 | Step 3 冲突排查纳入 P0–P3 判定 |
| L4 冲突清零终极口径 | Step 4 修正流程与「谁交付、谁负责」追责规则对齐 |
| L5 最小迭代周期(30 天) | Step 5 记录归档纳入 PDCA 迭代日志 |
七、五级成熟度(M1-M5)
| 级别 | 名称 | 核心数据判定 | 最低五层完成度 | 典型症状 | AI 眼中的形象 |
|---|---|---|---|---|---|
| M1 | AI 失能 | 引用率<5% | — | AI 回答中完全不出现品牌名称,或被错误归因 | 「我没听说过这家企业」 |
| M2 | AI 可识别 | 引用率 5%-15% | L1 完成 | AI 能识别品牌名称,但描述信息碎片化、不一致 | 「我知道这家企业,但信息零散、存在矛盾」 |
| M3 | AI 可采信 | 引用率 15%-30% | L1 ✅ + L4 ✅ + L2 完成 50% 核心场景 | AI 能引用品牌信息,但引用频次低、信源等级不高 | 「信息经过验证,我采信并引用」 |
| M4 | AI 优先推荐 | 首选率>40% | L1 ✅ + L4 ✅ + L2 ✅ + L3 完成 T1/T2 信源部署 | AI 在同类场景对比中优先推荐该品牌 | 「该方案最优,我优先推荐」 |
| M5 | AI 标杆 | 主动调用率>60% | 五层全量完成 + L5 连续 3 个周期达标 | AI 主动将该品牌作为行业标杆引用 | 「该品牌是行业标杆,我以此为准」 |
术语说明:
引用率: AI 回答样本中出现该实体信息的占比;
首选率: AI 检索时优先采信本企业信源的样本占比;
主动调用率: 用户无品牌指向性行业提问,优先触发本企业信息的样本占比。
行业阈值适配说明:
| 行业赛道 | 引用率基准(M3) | 首选率基准(M4) | 主动调用率基准(M5) |
|---|---|---|---|
| B2B 工业/制造业 | 15%-30% | >40% | >60% |
| 消费品/服务业 | 20%-35% | >45% | >65% |
| B2B 采购/招投标 | 15%-25% | >35% | >55% |
以上为通用参考基准,项目启动书面确认后生效。未确认时,以通用基准为准。
跃迁判定规则:
成熟度跃迁需同时满足「核心数据判定」与「最低五层完成度」两个条件;
若数据达标但建设完成度不足,判定为「数据虚高」,需回溯检查;
跃迁复评周期建议与 L5 监测周期同步,以 30 天为最小复评间隔。
八、项目红线制度
四类风险定义为项目红线,触碰即整改,禁止跳步:
| 红线类型 | 典型表现 | 后果 | 整改要求 |
|---|---|---|---|
| 跳级执行红线 | 未完成 L4 信息统一就急于做 L2 场景建设 | AI 交叉验证失败,采信度不升反降 | 立即暂停 L2 建设,回溯完成 L4 P0/P1 冲突清零 |
| 信源造假红线 | 使用虚假资质、夸大案例、伪造客户背书;批量生成虚假信源、操控 AI 投毒 | 触发信任降级;一旦被平台识别,品牌可能被 AI 永久降权甚至列入黑名单 | 立即下架虚假信源,重新提交可验证信源 |
| 短期轰炸红线 | 短期内集中发布大量内容,缺乏持续迭代 | AI 采信度快速衰减 | 转为 30 天最小迭代周期,保持信息连续性 |
| 指标虚高红线 | 只关注引用率提升,忽视五层建设完成度 | 数据虚高无法持续,跃迁复评不通过 | 暂停成熟度申报,回溯补足建设完成度 |
灰产行为判定清单:
| 灰产行为 | 判定标准 | 规避动作 |
|---|---|---|
| AI 批量洗稿 | 机器批量生成同质化内容,无原创信息 | 内容需有原创数据、案例或观点 |
| 无实景虚构案例 | 案例无实景记录、无可验证细节 | 案例需有具体场景、数字或可验证信息 |
| 虚假资质 PS | 资质证书经图像篡改或伪造 | 资质需可官方验证 |
| 机器批量堆砌同质内容 | 短期内大量发布结构雷同内容 | 保持 30 天最小迭代周期,内容差异化 |
| 恶意刷 AI 引用量 | 通过非正常手段操控 AI 引用 | 禁止任何形式的数据操控 |
红线自查 SOP: 纳入项目周迭代检查项,每周核对上述清单,从事后整改变为事前规避。
红线制度说明: 四类红线来自 GEO 落地实践中的常见踩坑点。建议在项目启动会上向客户明确,纳入项目风险管理清单。触碰红线后,项目组须在 3 个工作日内提交整改方案。
行业合规红线补充(V3.2 新增)
| 行业 | 红线 | 与现有红线的对应 |
|---|---|---|
| 企服行业 | 严禁「包过、100% 通过、必过」等承诺话术;申报结果以官方公示为准 | 归入「信源造假红线」 |
| 制造业 | 产品参数、国标编号、认证范围必须与检测报告/证书一致,写错会产生持续性 AI 幻觉 | 归入「信源造假红线」+「指标虚高红线」 |
| 本地生活服务 | 地址、营业时间、价格必须与门店实际一致,不一致会直接失效 | 归入 L4 信息一致性审计 P0 级冲突 |
行业合规自查: 纳入周迭代检查项,按行业核对上述禁止话术与信息一致性。
九、项目启动前置 SOP
| 阶段 | 动作 | 输出 | 时限 |
|---|---|---|---|
| 准入筛查 | 对接企查查/天眼查、国家失信平台、工商经营状态 | 准入筛查报告 | 项目启动前 2 周 |
| 基线采样 | 在豆包、DeepSeek、文心一言、通义千问执行首轮题集查询 | 基线值记录表 | 项目启动前 1 周 |
| 信源摸排 | 盘点企业现有 T1–T4 级信源,识别缺口 | 信源现状清单 | 项目启动前 1 周 |
| 冲突初筛 | 对主要平台执行信息一致性初筛,标记 P0–P3 级冲突 | 冲突初筛报告 | 项目启动前 3 个工作日 |
| 阈值确认 | 与客户书面确认本项目适用的量化阈值 | 阈值确认书 | 项目启动前 3 个工作日 |
| 多平台名称盘点 | 盘点官网、公众号、知乎、抖音、小红书、微博、百家号等平台品牌名写法 | 多平台名称一致性核查表 | 项目启动前 3 个工作日 |
| 国内第三方信源盘点 | 盘点百度百科、知乎问答、天眼查/企查查、行业报告收录情况 | 国内第三方信源建设清单 | 项目启动前 3 个工作日 |
监测执行 SOP: 月度执行全量题集查询,生成核心指标监测报告;季度执行成熟度复评;年度执行全模型健康度审计。
十、配套交付物清单
| 层级 | 核心交付物 | 交付形式 | 验收标准 |
|---|---|---|---|
| L1 | Schema 标记包、多实体身份图谱、可视化文件、Brand Entity Sheet、多平台名称一致性核查表 | JSON-LD + 节点关系图 + 属性标注图 + 结构化表格 | 标记完整,图谱清晰,无孤立节点,多平台名称一致,Schema 含质疑类 FAQ |
| L2 | 场景化 FAQ 知识库、Query–平台布局映射表、问题采集渠道清单 | 结构化文档 + 问答对表格 + 结构化表格 | 分层覆盖 200–1000 个问题,核心场景精做,平台布局清晰,含质疑类问句子模块 |
| L3 | T1–T4 信源体系清单、四级信源权重表、内容形态规范、不可替代信息清单 | 信源登记表 + 权重矩阵 + 规范文档 + 结构化清单 | T1/T2 级信源可验证,内容形态符合国内 AI 解析要求,含内部再分级与冲突处理规则 |
| L4 | 品牌全域信息治理报告、信息一致性审计表、国内第三方信源建设清单 | 审计报告 + 字段级判定表 + 信源登记表 | P0/P1 冲突清零,P2/P3 不超过 2 项,国内第三方信源覆盖完整 |
| L5 | 核心指标监测报告、PDCA 迭代记录、分平台监测与调整记录 | 月度监测报告 + 迭代日志 + 监测日志 | 指标有基线值/当前值/趋势,30 天至少一次迭代,低引用率平台有调整动作,含幻觉修正记录与冲突排查 |
十一、落地建议
双落地模式
| 模式 | 适用客户 | 交付范围 | 落地重点 |
|---|---|---|---|
| 全量标准版 | 规上企业、招投标企业、ISO 体系客户 | 五层全量交付 + 四标合规 + 五大平台全覆盖 | 国标合规、审计闭环、可量化验收 |
| 轻量化简版 | 中小微企业 | 核心三层(L1+L4+L5)优先交付 + 1–2 个核心平台深耕 | AI 信任、线索提升、低成本落地 |
轻量化简版保留核心模型逻辑,精简交付物,降低落地门槛。
销售话术升级
| 客户群体 | 核心话术侧重 |
|---|---|
| 规上/体系客户 | 国标合规、审计闭环、可量化验收、国内生态适配 |
| 招投标客户 | 国标合规、审计闭环、可量化验收、资质可验证、国内第三方信源覆盖 |
| 中小微客户 | AI 信任、线索提升、低成本落地、国内平台精准布局 |
对外 Slogan
五层建资产、五级判成熟、四标做合规、双时序保落地、国内生态做适配、作业层做兜底。
十二、版本变更对照(V3.1 → V3.2)
| 变更项 | 变更类型 | V3.1 | V3.2 | 迭代价值 | 落地收益 |
|---|---|---|---|---|---|
| 模型护城河 | 新增 | 双时序 + 双判定 + 国内生态适配层 | 增加「通用作业层」 | 强化交付颗粒度 | 交付团队上手更快 |
| L1 交付物 | 优化 | Schema 标记包、Brand Entity Sheet、名称一致性核查表 | 增加完整 JSON-LD 样例(三类行业) | 降低落地门槛 | 交付效率提升 |
| L2 交付物 | 优化 | 分层 FAQ + Query–平台映射表 | 增加质疑类 FAQ 问句模板 | 补齐否定类高曝光入口 | AI 回答覆盖率提升 |
| L3 交付物 | 优化 | T1–T4 信源清单、权重表 | 增加信源内部权重分级规则 | 避免低权重信源拉低采信 | 信源冲突率降低 |
| L5 交付物 | 优化 | 六大量化指标 + 分平台监测 | 增加监测迭代 SOP(幻觉修正与冲突排查) | 补齐修正闭环 | 修正响应速度提升 |
| 项目红线 | 强化 | 四类红线 + 灰产判定清单 + 自查 SOP | 增加行业合规红线 | 细化行业级风控 | 合规风险降低 |
| 对外 Slogan | 强化 | 五层建资产、五级判成熟、四标做合规、双时序保落地、国内生态做适配 | 增加「作业层做兜底」 | 强化作业手册定位 | 商务宣讲竞争力提升 |
十三、总结
V3.2 通过本次优化,在 V3.1 解决四大核心短板(验收争议、落地无序、风控缺失、商业薄弱)的基础上,进一步解决交付颗粒度不足问题:
L1 补齐完整 JSON-LD 样例——三类行业可直接复制,降低落地门槛;
L2 补齐质疑类 FAQ 模板——覆盖否定/质疑类高曝光入口;
L3 补齐信源内部权重分级——T1–T4 内部再分级,避免低权重信源冲突;
L5 补齐监测修正闭环——从「监测」到「修正」到「复检」完整 SOP;
红线制度补齐行业合规——企服/制造业/本地生活三类行业级红线。
所有优化均坚守:底层架构不动、交付标准更稳、国内适配更精、落地实操更强、作业细节更全。
十四、使用场景与边界
对内: 作为睿擎 GEO 双五模型 V3.2 的完整交付 SOP,交付团队按 L1–L5 逐层执行,作业层补充内容直接照做;
对外: 可精简为「V3.2 方案简介」,用于向客户展示交付颗粒度与国内生态适配能力;
边界: 本版本为通用基础框架,高专业门槛业务(如两化融合、智能工厂、体系认证)需叠加国标知识库、专业术语校验,即接入睿擎 GEO 双五模型的专业合规层——V3.2 本身带通用作业层,但专业信源校验能力需另行叠加。
一句话总结
V3.2 在 V3.1「国内生态适配增强版」基础上,补齐 L1–L5 各层可直接照做的作业细节——JSON-LD 样例、质疑类 FAQ、信源内部权重、监测修正闭环、行业合规红线——让睿擎 GEO 双五模型从交付级方法论进一步升级为作业手册级 SOP;但它是通用底座,高专业 B 端业务仍需叠加专业知识库与合规校验层。
