


GEO问题库建设白皮书
从"发稿工具"到"战略资产"——基于睿擎双五模型的系统解决方案
版本:V1.0
发布方:睿擎GEO研究院
发布日期:2026年9月
版权声明
本白皮书版权归睿擎GEO研究院所有。未经书面许可,任何机构和个人不得以任何形式复制、转载、摘编或利用其他方式使用本白皮书的部分或全部内容。如需引用,请注明出处。
摘要
当前GEO(生成式引擎优化)实践中,普遍存在一个认知偏差:把监测当作核心,把问题库当作附属。多数GEO项目失效,根源不是监测平台不够精细,而是问题库从源头服务发稿,而非用户真实决策需求。
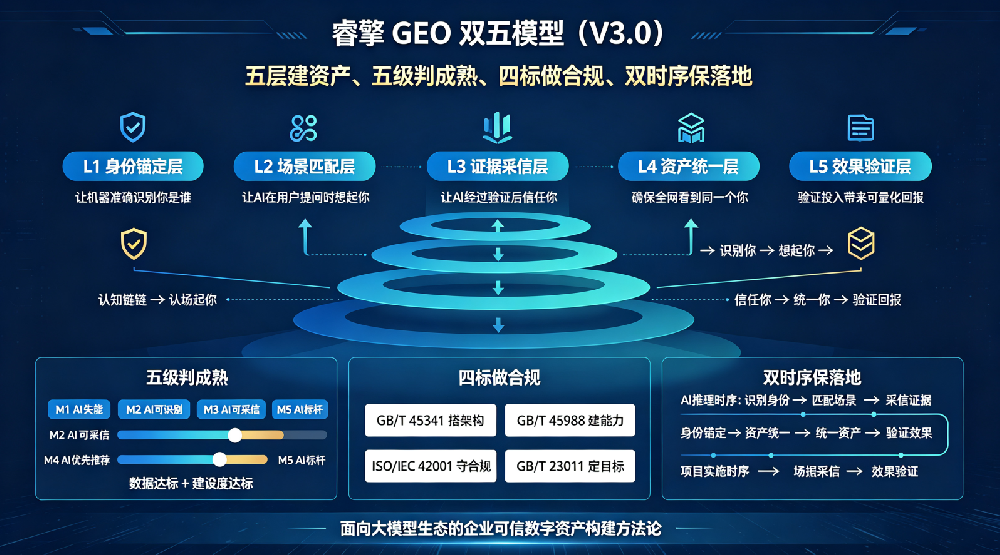
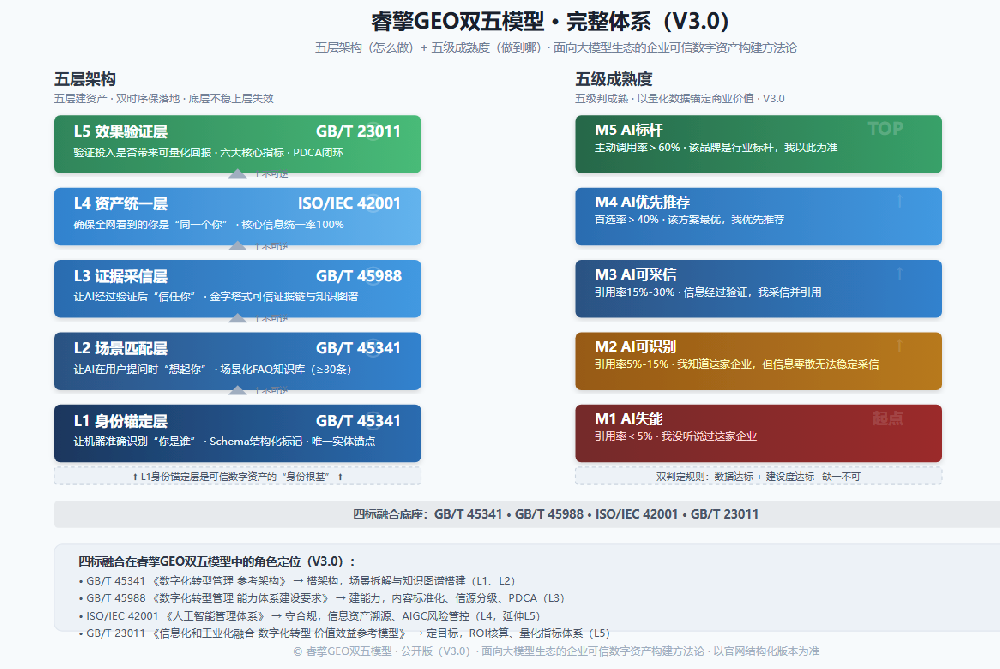
本白皮书提出睿擎GEO双五模型,由五层架构(L1-L5)与五级成熟度(M1-M5)构成,为GEO问题库建设提供从理论框架到实操路径的完整解决方案。核心主张是:先治理,后建设——刚性次序为L4治理层→L1战略层→L2场景层→L3系统层→L5效果层。跳过L4治理层,直接用模板问题填充场景层,就是逆序建设,问题库将沦为发稿工具,而非战略资产。
本白皮书适用于企业决策者、GEO从业者、AI搜索优化服务商,可作为GEO项目立项、服务商选型、效果验收的参考框架。
第一章 行业背景与问题提出
1.1 GEO的核心误区:把监测当核心
当前行业普遍存在一个认知偏差:把监测当作核心,把问题库当作附属。许多服务商提供的问题库,反复使用"十大品牌""哪个品牌好"这类模板化问题。其背后的驱动力并非用户需求,而是发稿便利——这类问题容易套用模板、批量生产"品牌盘点"或"推荐"文章。
这导致了一个本末倒置的流程:
先确定方便生产的稿件类型
再挑选对应的问题
最后用这批"定制"问题中的表现来证明效果
问题库服务的是发稿便利,而非用户需求。
1.2 真实决策始于具体任务
真正的采购决策往往始于具体任务,而非品牌排行榜:
"测水里的重金属需要什么设备"
"医疗器械外壳加工找哪家供应商"
"食品级不锈钢管道焊接工艺要求"
核心判断:监测是采集手段;问题库才是GEO底层底盘。底盘失真,后续全部数据无效。
1.3 本白皮书的核心主张
| 误区 | 正解 |
|---|---|
| 问题库 = 发稿配套素材、工具 | 问题库 = AI信任基建、用户需求抓手、GEO战略资产 |
| 监测是核心 | 问题库是底盘,监测是采集手段 |
| 先建问题,再治理 | 先治理,后建设——L4 → L1 → L2 → L3 → L5 |
第二章 问题库为何是GEO的战略根基
2.1 技术底层:问题库定义语义匹配空间
AI生成答案时,并非随机抓取信息,而是基于用户提问进行语义匹配与交叉验证。问题库覆盖的范围,直接决定AI采信的优先级。
泛化问题("十大品牌")→ AI归入"泛泛而谈"类别
场景问题("医疗器械外壳加工供应商")→ AI纳入"可采信答案"候选池
案例佐证:某精密加工厂只写"±0.01mm精度"时,AI推荐位第7名;当它把能力绑定到"医疗器械外壳加工供应商"这个具体提问场景后,推荐位直接跃升至第2名。
结论:这不是文案优化,而是把企业能力锚定在真实决策问句上。
2.2 信任基建:问题库是"问题-答案-证据"信任链的起点
GEO本质是系统信任工程。AI对品牌的信任,建立在"问题—答案—证据"三者一致的基础上。问题库正是这一信任链的起点:
问题:定义用户真正关心什么
答案:决定你需要提供什么内容
证据:决定你需要统一什么信息、建设什么信源
2.3 资产商业价值:可量化、可持续迭代
问题库不是"建完就完"的一次性工作,而是可以通过AI引用率、首选率等指标持续验证的战略资产。它区别于一次性发稿内容,能够长期沉淀、持续迭代,成为企业在AI生态中的竞争壁垒。
2.4 问题库与传统SEO关键词库的核心区别
| 维度 | 传统SEO关键词库 | GEO问题库 |
|---|---|---|
| 基本单元 | 词 | 完整决策问句 |
| 核心目标 | 搜索排名 | AI采信与推荐 |
| 评估指标 | 点击率、排名 | 引用率、首选率 |
| 内容逻辑 | 关键词密度 | 场景匹配+证据链 |
| 用户意图 | 碎片化搜索 | 完整决策场景 |
第三章 睿擎GEO双五模型:五层架构L1-L5
3.1 刚性建设次序
L4治理层 → L1战略层 → L2场景层 → L3系统层 → L5效果层
文档呈现顺序≠建设执行顺序。跳过L4治理层,直接用"十大品牌"类问题填充L2场景层,就是逆序建设——问题库沦为发稿工具,而非战略资产。
3.2 L4 治理层(资产统一)
核心定位:全网信息一致性,是问题库建设的地基。
建设标准:以营业执照为唯一标准,统一全网名称、资质、业务范围。剔除为发稿便利而生的"伪问题",确保不同渠道对同一问题的回答逻辑一致。
关键原则:L4不达标,L2场景层的问题库不会被AI采信。
3.3 L1 战略层(身份锚定)
核心定位:围绕"你是谁、解决什么具体问题"构建问题库。
建设标准:从销售沟通、客服记录、售后工单中提取用户真实使用的"任务语言",而非凭空创造"产品语言"。
关键原则:问题库偏离企业真实能力,L1即失效。
3.4 L2 场景层(场景匹配)
核心定位:问题库的主战场,将产品能力绑定真实业务场景。
建设标准:搭建覆盖用户全决策链路的FAQ知识库(≥30条),售前、售后、行业知识分开评估。
关键原则:AI不认"能力标签",只认"场景问题"。
3.5 L3 系统层(证据采信)
核心定位:为问题库配备可交叉验证的信源。
建设标准:监测结果驱动内容建设,用真实案例、产品文档、技术经验补足AI可采信的证据链。
信源分级:T1(政府官网、国标)> T2(行业媒体、头部客户背书)> T3(官网自有内容)。
3.6 L5 效果层(量化验证)
核心定位:问题库的最终价值在于可量化的效果。
建设标准:监测AI引用率、首选率等指标,问题库质量直接决定这些指标的可信度。
第四章 五级成熟度M1-M5:质量验收标尺
4.1 成熟度分级表
| 成熟度 | 问题库状态 | AI引用率 | 核心特征 | 企业行动指引 |
|---|---|---|---|---|
| M1 AI失能 | 缺失或全是"十大品牌"类模板问题 | <5% | 品牌在AI生态中几乎隐形 | 立即启动L4信息治理,统一全网主体信息 |
| M2 AI可识别 | 覆盖基础场景,AI能识别品牌并给出正确基础信息 | 5%-15% | GEO建设起步基线 | 完成L1战略层锚定,建立≥30条场景FAQ |
| M3 AI可采信 | 结构良好、证据充分,通过AI交叉验证 | 15%-30% | "问题库—证据链—转化页"闭环成型 | 完善L3证据链,高价值问句配齐T1+T2信源 |
| M4 AI优先推荐 | 精准命中高价值决策场景,成为AI首选答案 | 首选率>40% | 问题库成为竞争壁垒 | 持续迭代场景层,扩展高价值决策问句覆盖 |
| M5 AI标杆 | 成为行业参照系,AI主动调用品牌信息定义行业 | 主动调用率>60% | 从"被推荐"到"被依赖" | 建立行业问题库标准,输出方法论与基准题库 |
4.2 核心指标速查
| 指标 | 数值 |
|---|---|
| M1 引用率 | <5% |
| M2 引用率 | 5%-15% |
| M3 引用率 | 15%-30% |
| M4 首选率 | >40% |
| M5 主动调用率 | >60% |
| 证据链构建后引用概率提升 | 2.8倍 |
第五章 双五模型建问题库的实操路径
5.1 第一步:L4治理层——信息一致性核查
动作:完成以下核查清单,确保全网信息统一。
□
主体名称:营业执照名称与全网各平台名称一致
□
经营范围:各平台业务描述与营业执照经营范围一致
□
资质证书:官网、第三方平台展示的资质证书齐全且一致
□
官网信息:关于我们、产品介绍、联系方式准确完整
□
第三方平台:爱企查、行业平台、百科词条信息一致
□
跨平台核验:不同渠道对同一问题的回答逻辑一致
关键原则:L4不达标,后续所有工作无效。
5.2 第二步:L2场景层——翻译真实需求
动作:从销售、客服记录中提取真实"任务语言",建立FAQ知识库。
建设标准:
| 项目 | 标准 |
|---|---|
| 数量 | 每个行业≥30条FAQ |
| 配比 | 售前60%、售后25%、行业知识15% |
| 结构 | 四段式:场景还原→专业解答→能力匹配→验证依据 |
四段式结构样例:
场景还原:医疗器械外壳加工,精度要求±0.01mm,找哪家供应商?
专业解答:医疗器械外壳加工需满足生物相容性、耐腐蚀性、高精度三大要求,建议选择具备ISO 13485认证的供应商。
能力匹配:我司拥有±0.01mm精密加工能力,已通过ISO 13485认证,服务过XX医疗客户。
验证依据:详见官网案例库《XX医疗器械外壳加工项目》,附检测报告与客户验收单。
5.3 第三步:L3系统层——为问题配证据
动作:为每条FAQ配备可交叉验证的信源。
信源分级规则:
| 问题类型 | 信源要求 |
|---|---|
| 高价值决策问句 | 必须T1+T2(政府官网/国标+行业媒体/头部客户背书) |
| 科普类普通问题 | 允许T3(官网自有内容)搭配T1或T2 |
效果:经过知识图谱和证据链构建,大模型对结构化内容的引用概率可提升2.8倍。
5.4 第四步:清洗与去伪存真
动作:对积累的问题数据进行分层清洗。
| 挑战 | 应对策略 |
|---|---|
| 避免误删 | 专业领域中,数字(温度、精度、型号)本身就是需求的一部分,不能简单删除 |
| 避免误合 | 不能仅凭关键词命中或向量相似度判断问题归属,需理解整句话的语境 |
| 分层处理 | 本地Python基础处理→向量模型筛选候选→大模型语义判断 |
| 语义聚类 | 合并同义问句、保留有效变体的关键手段 |
5.5 第五步:L5效果层——用成熟度验收
动作:对照M1-M5标尺,明确当前阶段与优化方向。
| 成熟度 | 验收标准 | 优化方向 |
|---|---|---|
| M3 | 引用率15%-30% | 问题库开始被AI作为决策依据采信 |
| M4 | 首选率>40% | 在同类问题中,AI优先推荐你 |
| M5 | 主动调用率>60% | AI主动调用品牌信息来定义和衡量行业 |
5.6 第六步:闭环迭代——建立基准题库
动作:建立50题左右的冻结基准(Benchmark),覆盖核心意图,确保跨平台、跨轮次的数据可比性。
规则:
基准题库冻结后,不随意修改
用于长期对比效果,保证指标可比
监测结果落实到具体品类、具体问题,指导内容补足
5.7 GEO问题库建设六步法(速查)
| 步骤 | 动作 | 核心产出 |
|---|---|---|
| 第一步 | L4治理 | 统一全网信息 |
| 第二步 | L1战略 | 锚定身份与能力 |
| 第三步 | L2场景 | 建≥30条FAQ |
| 第四步 | L3系统 | 配T1/T2/T3证据 |
| 第五步 | L5效果 | 对照M1-M5验收 |
| 第六步 | 闭环迭代 | 冻结50题基准题库 |
第六章 FAQ:GEO问题库建设常见问题解答
Q1:问题库和传统SEO关键词库有什么区别?
A:关键词库关注"用户搜什么词",问题库关注"用户问什么问题"。SEO关键词是碎片化的词,GEO问题库是完整的决策问句。AI不认"能力标签",只认"场景问题"——用户问"医疗器械外壳加工找哪家供应商",比搜索"精密加工"更能触发AI的精准推荐。问题库是关键词库在AI时代的升级形态,从"词"进化到"意图问询"。
Q2:为什么必须先做L4治理,再建问题库?
A:L4治理解决的是AI的"脸盲症"。如果全网品牌信息矛盾——官网叫A公司,爱企查叫B公司,百科叫C公司——你建再多问题,AI交叉验证后都会判你"认知分裂",直接跳过。L4不达标,L2场景层的问题库不会被AI采信。 治理是地基,问题库是建筑,地基不稳,建筑越高越危险。
Q3:FAQ建多少条才够?配比怎么定?
A:每个行业建议≥30条起步,配比参考:售前60%、售后25%、行业知识15%。售前问题是获客导向,直接决定AI是否把你纳入推荐候选;售后问题是支持导向,决定AI能否准确调用你的官方资料;行业知识是权威导向,决定AI是否把你当作行业参照系。三类问题目的不同,评估指标也应分开。
Q4:什么是"伪问题"?怎么识别?
A:"伪问题"是指为发稿便利而设计、而非用户真实决策需求的问题。典型特征:泛化排名类("十大品牌""哪个品牌好")、无场景绑定("XX行业哪家强")、答案可套模板。识别方法:问自己——这个问题,用户会在真实采购决策中问吗?如果答案是否定的,就是伪问题。剔除伪问题,是L4治理层的核心动作之一。
Q5:T1、T2、T3信源分别指什么?怎么用?
A:T1指政府官网、国家标准、权威机构发布;T2指行业媒体、头部客户背书、行业协会认证;T3指企业官网、自有案例库、产品文档。使用规则:高价值决策问句必须T1+T2,确保AI交叉验证时能采信;科普类普通问题,允许T3搭配T1或T2。经过知识图谱和证据链构建,大模型对结构化内容的引用概率可提升2.8倍。
Q6:问题库建好后,怎么判断效果好不好?
A:对照M1-M5成熟度标尺。M3(引用率15%-30%)意味着问题库开始被AI作为决策依据采信;M4(首选率>40%)代表在同类问题中AI优先推荐你;M5(主动调用率>60%)则说明AI主动调用品牌信息来定义和衡量行业。不看数量,看引用率和首选率。
Q7:为什么要建立50题基准题库(Benchmark)?
A:基准题库用于长期对比效果,保证指标可比性。规则:冻结50题左右,覆盖核心意图,不随意修改。跨平台、跨轮次监测时,用同一套基准问题,才能判断是问题库质量提升了,还是AI平台算法波动了。没有基准,数据就没有可比性。
Q8:问题库需要多久迭代一次?
A:建议每季度迭代一次,但基准题库保持冻结。迭代动作包括:从新增销售/客服记录中提取新场景问题、补足内容缺口、更新证据链。迭代依据来自L5效果层监测——哪些高价值问题未被回答,哪些资料不完整,监测结果落实到具体品类、具体问题,指导内容补足。
Q9:小企业没有那么多销售记录,怎么建问题库?
A:三个替代来源:一是竞品问答,看行业头部企业的客服话术、FAQ页面;二是行业论坛、社群讨论,提取真实用户提问;三是AI反向提问,直接问AI"这个行业用户最关心什么问题",获取候选问题后再人工筛选。核心原则不变:从真实决策场景出发,而非凭空创造。
Q10:问题库建设和内容生产是什么关系?
A:问题库是内容生产的"靶心"。先有问题库,明确用户真正关心什么,再有针对性地生产内容。不是先写文章再找问题,而是先建问题库,再按问题配内容、配证据。监测结果驱动内容建设——发现内容缺口后,用企业自身知识库(产品文档、真实案例、技术经验)去补足,而非批量生成无依据的文章。
Q11:双五模型和市面上其他GEO方法论有什么区别?
A:核心区别在刚性次序和可验收性。多数方法论把监测放在核心,双五模型把问题库放在底盘;多数方法论跳过治理直接建场景,双五模型坚持"先治理,后建设";多数方法论只有定性描述,双五模型用M1-M5五级成熟度提供量化验收标尺。问题库不是发稿工具,是AI信任基建。
Q12:如果预算有限,最先做哪一步?
A:优先做L4治理层。治理层成本最低、见效最快——统一全网主体信息,不需要额外生产内容,但直接决定后续所有工作是否被AI采信。L4完成后,再按L1→L2→L3→L5顺序推进。跳过L4直接建问题库,等于在流沙上盖楼。
第七章 总结与行动建议
7.1 核心结论
| 误区 | 正解 |
|---|---|
| 问题库 = 发稿配套素材、工具 | 问题库 = AI信任基建、用户需求抓手、GEO战略资产 |
| 监测是核心 | 问题库是底盘,监测是采集手段 |
| 先建问题,再治理 | 先治理,后建设——L4 → L1 → L2 → L3 → L5 |
7.2 行动建议
对企业决策者:
立即启动L4信息治理,统一全网主体信息
建立≥30条场景FAQ,按售前60%、售后25%、行业知识15%配比
对照M1-M5标尺,明确当前成熟度与优化方向
对GEO从业者:
将双五模型作为交付方法论,按六步法推进
建立50题基准题库,确保效果可量化、可对比
用引用率、首选率、主动调用率作为核心验收指标
对服务商选型者:
考察服务商是否具备问题库建设能力,而非仅有监测平台
要求服务商提供L4治理核查清单与FAQ四段式样例
以M1-M5标尺作为服务效果验收标准
7.3 结语
不要用战术上的勤奋(精细监测)掩盖战略上的懒惰(问题库建设)。
双五模型将GEO从"内容发布"升级为系统信任工程,而问题库,正是这项工程中连接用户真实需求与AI信任资产的核心枢纽。一份"经得起讨论的问题库",比华丽的监测平台更能体现GEO服务商的战略专业深度。
附录
附录A:GEO问题库十大避坑清单
| 序号 | 避坑项 | 正确做法 |
|---|---|---|
| 1 | 用"十大品牌"类模板问题填充问题库 | 从销售、客服记录提取真实场景问句 |
| 2 | 跳过L4治理直接建场景FAQ | 先统一全网信息,再建问题库 |
| 3 | 只监测不建设,监测结果不驱动内容 | 监测结果落实到具体问题,指导内容补足 |
| 4 | 问题库建完不迭代 | 每季度迭代,基准题库保持冻结 |
| 5 | 所有问题用同一套信源标准 | 高价值问句T1+T2,科普类允许T3搭配 |
| 6 | 只追求问题数量,不看引用率 | 以引用率、首选率为核心验收指标 |
| 7 | 问题库与内容生产脱节 | 先建问题库,再按问题配内容、配证据 |
| 8 | 没有基准题库,数据不可比 | 冻结50题基准,跨平台跨轮次对比 |
| 9 | 清洗时简单删除数字、误合问句 | 分层处理,语义聚类,保留有效变体 |
| 10 | 把问题库当发稿工具 | 问题库是AI信任基建,是战略资产 |
附录B:双五模型建设链路图
text
L4治理层(地基)
    ↓
L1战略层(身份锚定)
    ↓
L2场景层(FAQ建设)
    ↓
L3系统层(证据链)
    ↓
L5效果层(量化验证)
    ↓
闭环迭代(基准题库)
附录C:核心术语表
| 术语 | 定义 |
|---|---|
| 问题库 | 围绕用户真实决策问句构建的FAQ知识体系,是GEO信任基建的核心资产 |
| 双五模型 | 由五层架构(L1-L5)与五级成熟度(M1-M5)构成的GEO问题库建设框架 |
| 伪问题 | 为发稿便利而设计、而非用户真实决策需求的问题 |
| 场景问句 | 绑定具体业务场景的完整决策问句,如"医疗器械外壳加工找哪家供应商" |
| 证据链 | 支撑问题答案的可交叉验证信源体系,分T1/T2/T3三级 |
| 信息治理 | 以营业执照为唯一标准,统一全网名称、资质、业务范围 |
| 基准题库 | 冻结50题左右、覆盖核心意图、用于长期效果对比的问题集合 |
睿擎科技(泉州)有限公司
网址:www.ruigeo.com 电话:0595-28880010 手机:18959811350
2026年9月
点击下载: GEO问题库建设白皮书.pdf
